模型调用的准备工作
1.大模型的调用
在 LangChain 0.3 时代的文档中,Model I/O 包含三部分:输入提示(Format)、调用模型(Predict)、输出解析(Parse),分别对应 Prompt Template、Model 和 Output Parser。
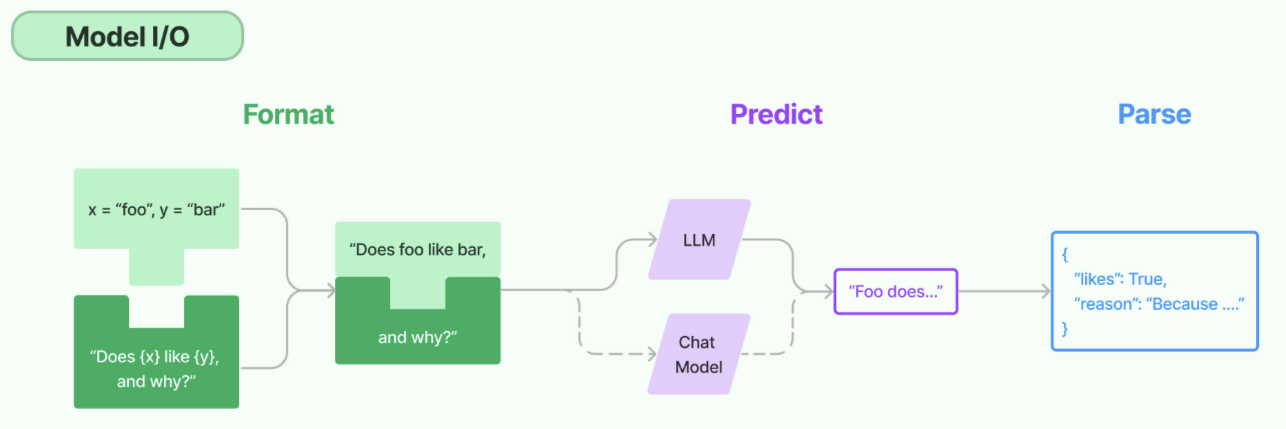
关于模型调用模块,如今对话模型已是主要形式。这要从历史说起:
在 GPT-3 时代,大模型以 补全模型 为主,只能以类似“成语接龙”的方式对文本进行补全,并且实际运行效果也 非常不稳定。此时 LangChain 借助高层封装的 API,能够让模型完成对话、调用外部工具,甚至结构化输出等功能,为开发者提供了极大的便利。
伴随着 GPT-3.5 模型的发布,对话模型 正式登上历史的舞台,并逐渐 成为主流。而得益于对话模型更强的指令跟随能力,很多 GPT-3 需要借助 LangChain 才能完成的工作,已经成为 GPT-3.5 原生自带的一些功能。
因此,本章只涉及对话模型的创建与调用,不再讨论非对话的补全模型。
2.模型初始化的分类方式
简单说:用谁的 API、以什么方式、把模型创建在哪里。
角度 1:调用谁家的 API
- 使用模型提供商的库
- 使用 LangChain 统一方式(推荐)
角度 2:模型初始化时,几个重要参数(如 base_url、api_key)的存放位置不同:
- 使用配置文件(推荐)
- 硬编码:写在代码文件中
角度 3:调用的模型所在位置
- 在线部署的大模型
- 本地部署的大模型
说明
LangChain 作为一个“工具”,本身不提供任何模型,而是依赖第三方集成各种大模型。这里的关键就是:模型到底部署在哪里。
3.线上大模型服务平台
有许多提供大模型 API 服务的平台,注册、充值并创建 API-Key 后,即可用 API-Key 与 base_url 调用该平台的模型。
| 平台 | 网址 | 备注 |
|---|---|---|
| OpenRouter | https://openrouter.ai/ | 全球主流,含国外模型 |
| CloseAI | https://platform.closeai-asia.com/ | 亚洲最大,含国外模型 |
| 阿里云百炼 | https://bailian.console.aliyun.com/ | 企业端友好 |
| 硅基流动 | https://www.siliconflow.cn/ | 性价比高,适合个人 |
| 百度千帆 | https://console.bce.baidu.com/qianfan/overview | 主打百度生态 |
| 火山引擎 | https://console.volcengine.com/ark/ | 主打字节多模态生态 |
配置上述任一平台时,都需要三个要素:模型名、api-key、base-url。
4.依赖安装
开发中会涉及多个库的安装,这里统一声明在 requirements.txt 中。LangChain 版本迭代较快,不同版本之间可能存在兼容问题,因此课程通过 requirements.txt 固定主要依赖版本。
用法:将 requirements.txt 放到项目目录下,在已激活的 langchain1.2 环境中执行:
pip install -r .\requirements.txt后续部分章节会单独列出该章涉及的核心库,便于理解,无需重复安装——它们都已包含在 requirements.txt 中。