LangSmith 基本使用
1.LangSmith 概述
1.1 什么是 LangSmith
LangSmith 是 LangChain 生态系统中专门用于 LLM(大语言模型)应用调试、监控、评估和管理的平台。
🔍 追踪(tracing):记录每次 LLM 调用的详细信息
📊 监控(monitoring):实时查看应用性能
🐛 调试(debug):排查问题和优化性能
📈 评估(evaluate):系统化测试 LLM 应用
1.2 具体功能
1.2.1 核心应用与开发
Tracing(追踪)
功能:这是 LangSmith 最核心的功能。它会完整记录你大模型应用的每一次调用链路(Trace)。
作用:当你的 Agent(智能体)或 RAG 系统运行变慢或报错时,点击进入对应的项目(如后文截图里的
langchain1.2_tutorial),你可以看到每一步具体的 Prompt 是什么、模型返回了什么、消耗了多少 Token,以及每一个链条节点的耗时,非常方便排查 Bug 和优化性能。
Monitoring(监控)
功能:提供生产环境的高级数据可视化看板。
作用:帮你从宏观角度监控应用在一段时间内的运行状况。你可以看到 Token 消耗趋势、QPS(每秒请求数)、错误率、平均延迟(Latency)以及成本预估。适合应用上线后观察系统的稳定性和开销。
Datasets & Experiments(数据集与实验)
功能:用于管理测试数据集并运行对比实验。
作用:你可以把用户的真实输入、特定的边界情况(Edge Cases)存为数据集。当你修改了 Prompt 或更换了底层大模型时,可以在这里运行自动化对比测试,直观看到新旧版本在同一批测试集上的表现差异。
Evaluators(评估器)
功能:配置和自动化评估任务。
作用:大模型的输出往往难以用传统的断言(Assert)来测试。这里允许你配置基于规则(如关键词匹配)或基于模型(LLM-as-a-judge)的评估指标(如:答案相关性、是否包含幻觉等),对追踪到的数据或实验结果进行自动打分。
Annotation Queues(标注队列)
功能:人工反馈与数据清洗工具。
作用:在应用开发或初上线阶段,你可以把一部分痕迹(Traces)发送到标注队列中,让团队中的核心成员、业务专家或人工客服进行手动打分、纠正回答或贴标签,这些高质量的人工标注数据后续可直接用于微调模型或充当测试集。
1.2.2 提示词与调试工具
Prompts(提示词管理)
功能:类似“提示词版的 GitHub”。
作用:把 Prompt 从代码中解耦出来,统一在云端管理。你可以在这里对 Prompt 进行版本控制(如
v1、v2),直接在代码中通过 API 动态拉取最新的提示词。它还支持团队协作和 Prompt 的分享。
Playground(演练场)
功能:一个网页端的模型交互界面。
作用:无需写任何代码,直接在这里选择不同的模型(如 OpenAI、Anthropic 或是本地模型),快速微调并测试你的 Prompt 效果,还可以一键将调整好的 Prompt 保存到上方的 Prompts 仓库中。
Studio(工作室)
功能:通常与 LangGraph 深度集成,提供可视化的图形交互界面。
作用:如果你的应用是基于图结构(Graph-based)的复杂 Agent 架构,Studio 可以让你可视化地看到状态机(State)在各个节点之间的流转,甚至支持在某个节点“暂停”,手动修改数据后再继续向下执行,是调试复杂智能体交互的利器。
Context Hub(上下文中心)
功能:管理全局上下文或通用组件配置。
作用:用于存放可在多个项目或 Prompt 中复用的公共上下文模板、全局变量或系统预设提示。
1.2.3 部署与沙盒
Deployments(部署)
功能:一键将你的 LangChain 应用或 LangGraph Agent 部署为线上可用的 API 服务(通常依托于 LangGraph Cloud)。
作用:提供开箱即用的生产端点,帮你处理高并发、队列管理和状态持久化,让你专注于编写业务逻辑。
Sandboxes(沙盒)
功能:提供轻量级的在线运行和测试环境。
作用:在不污染生产环境的前提下,供开发人员安全地试运行、测试新部署的 Agent 或执行自动化脚本。
现阶段怎么用
建议先重点关注 Tracing(观察项目里的调用细节)和 Playground(快速调优提示词)。当应用结构开始走向复杂(比如引入了复杂的 RAG 检索或多 Agent 协同)时,再逐步引入 Datasets 做量化评估,并利用 Studio 做可视化调试。
2.准备账号
2.1 注册或登录
步骤1:访问官网
访问 LangSmith 官网:https://smith.langchain.com/
步骤2:自由选择注册或登录方式
支持 Google、GitHub 或邮箱等方式,任选一种完成登录。
步骤3:登录成功
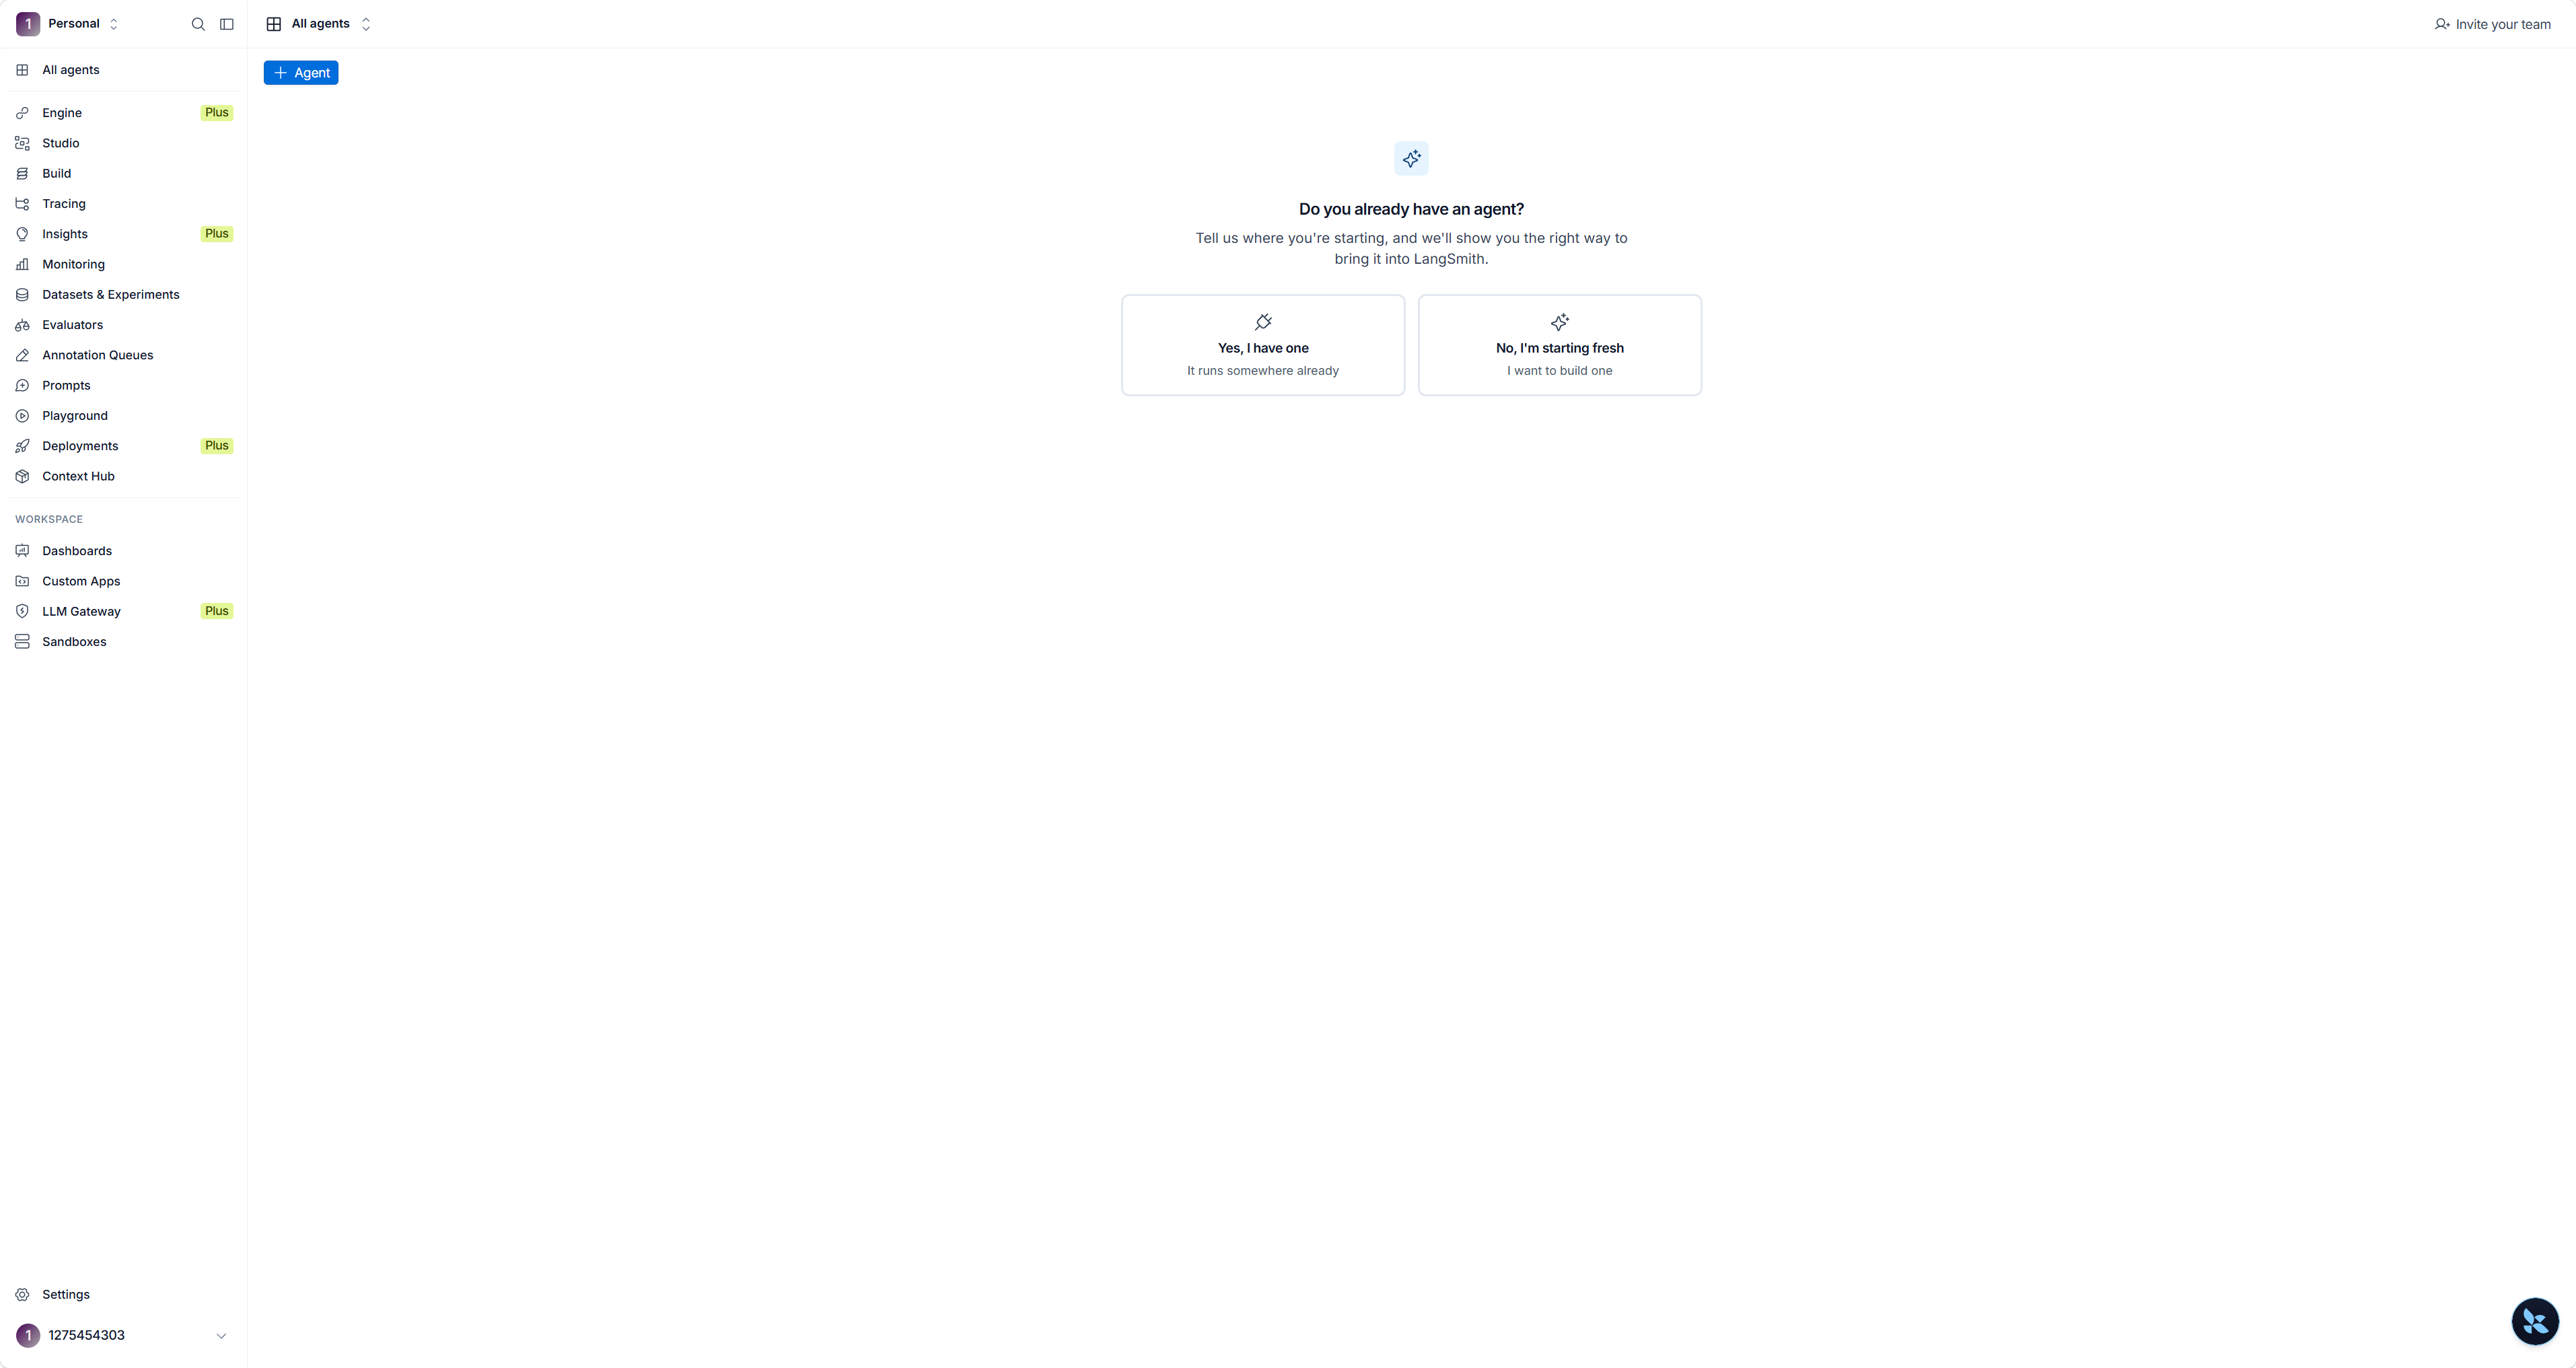
登录后进入主界面(All agents),左侧是功能导航,中间会问你“是否已经有 Agent”:
2.2 获取 API_KEY
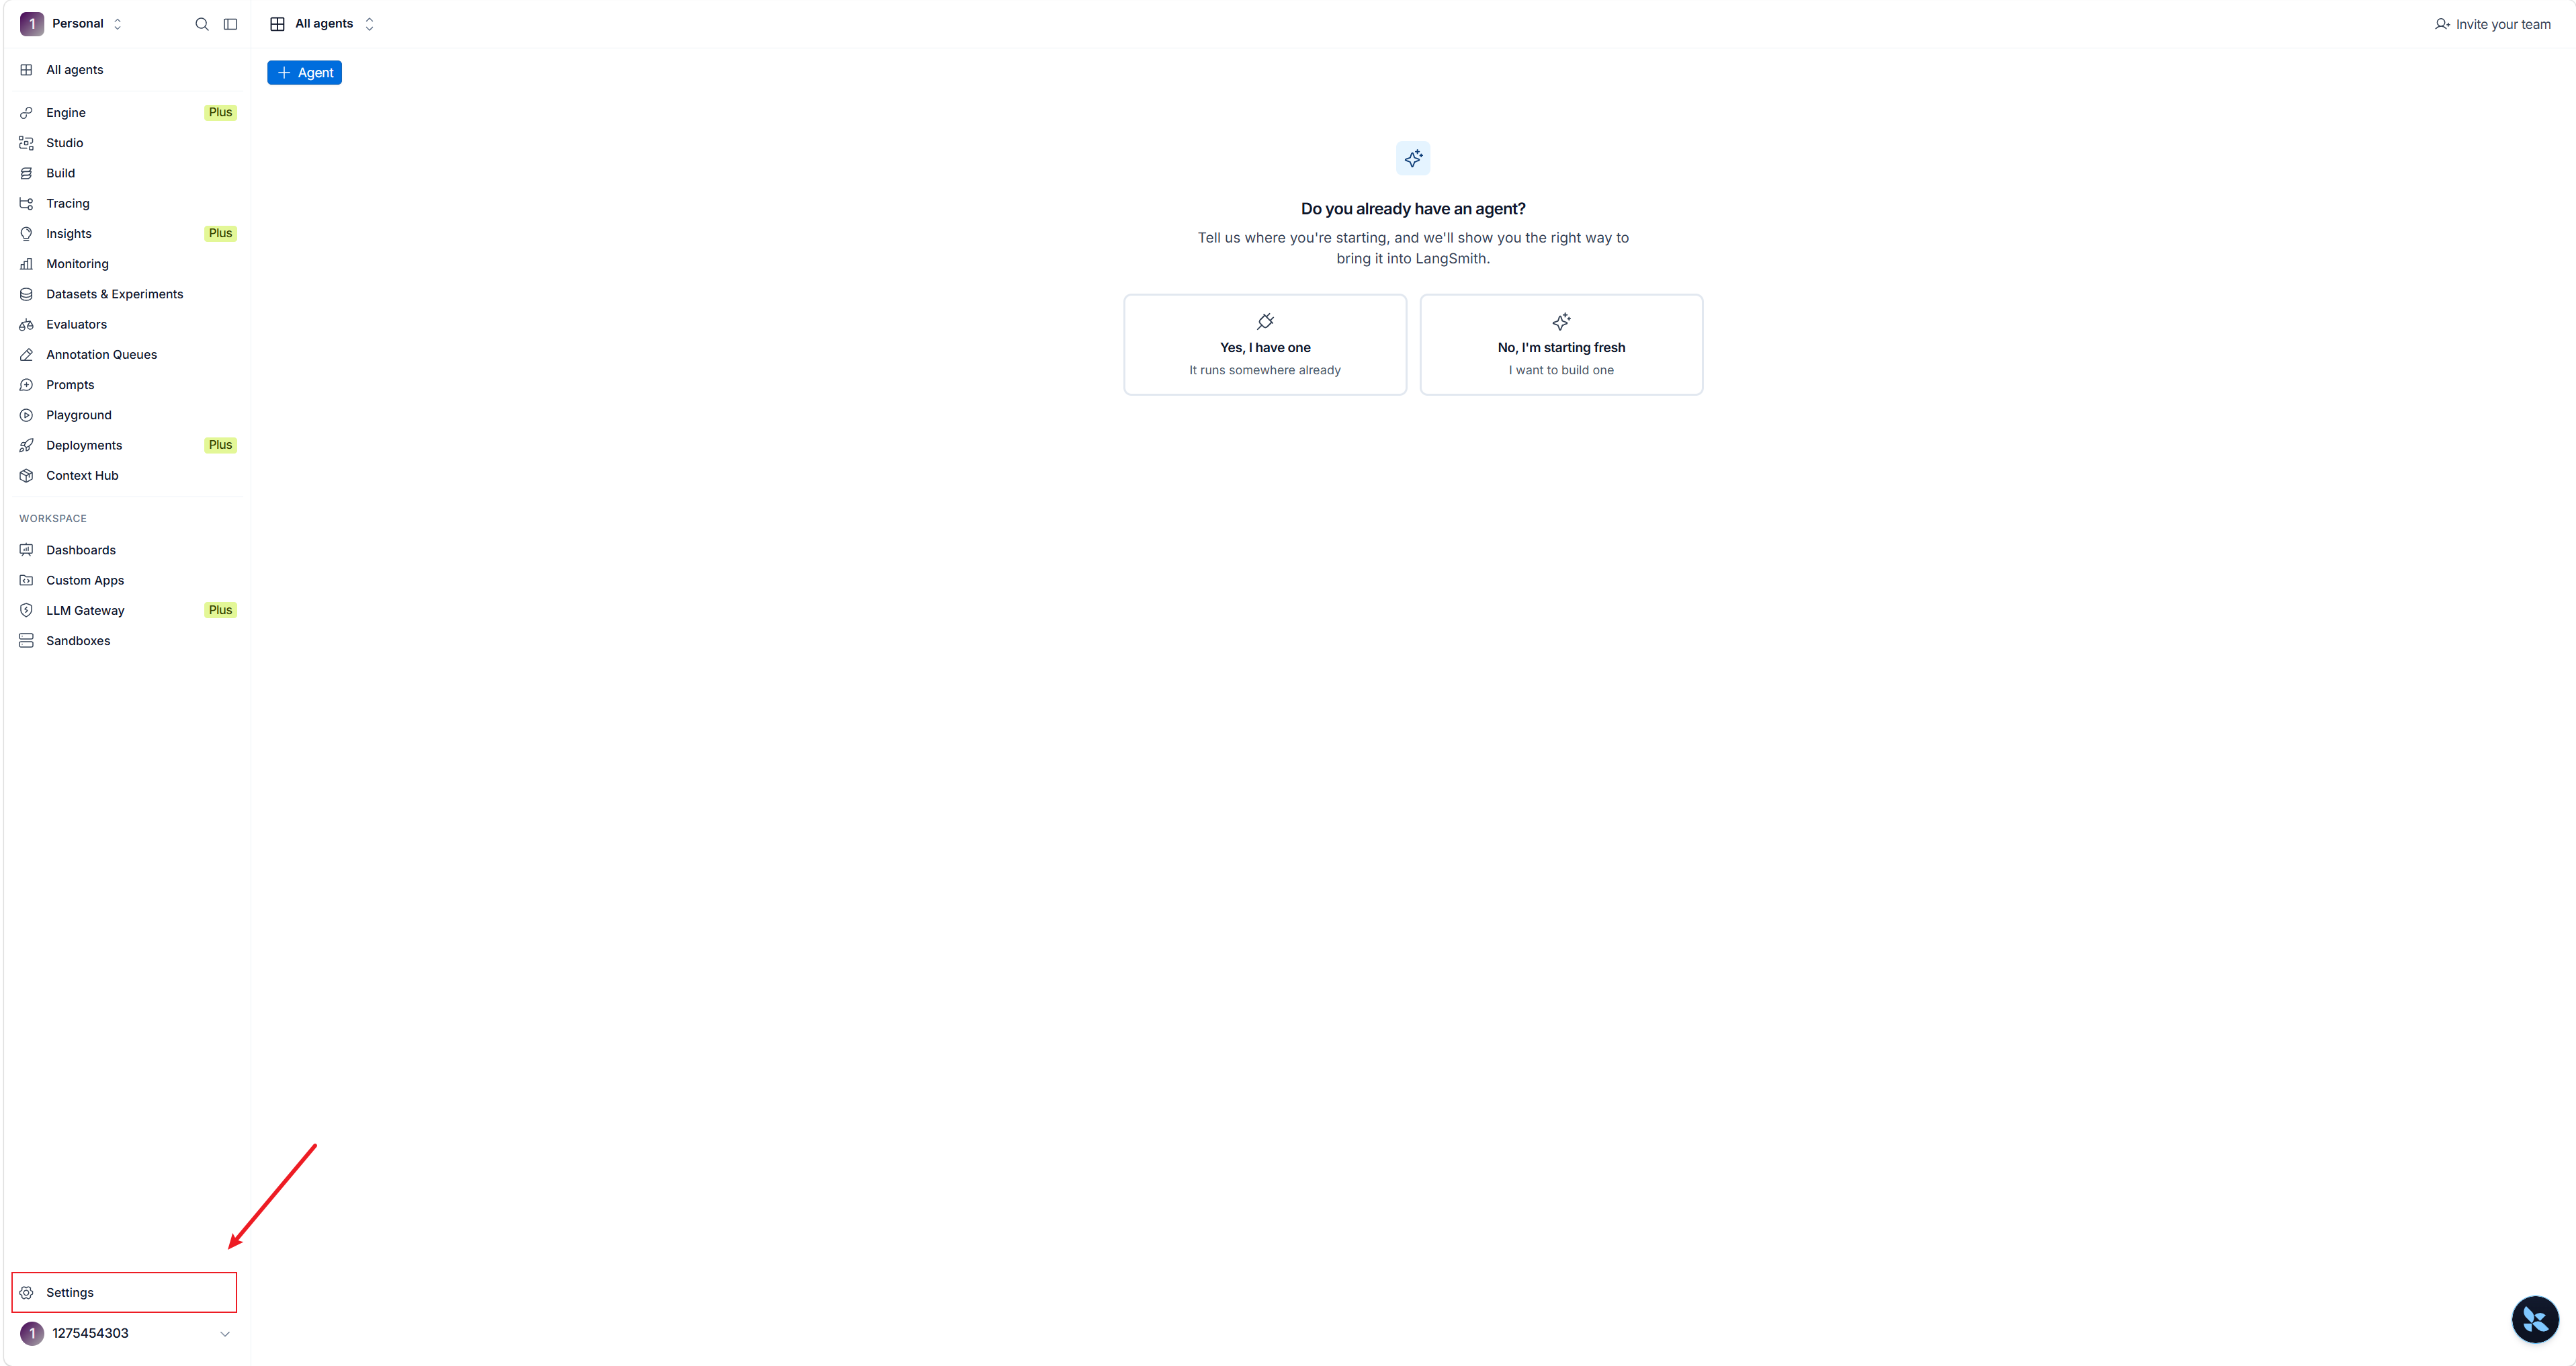
步骤1:打开设置
点击左下角的 Settings 进入账户设置:
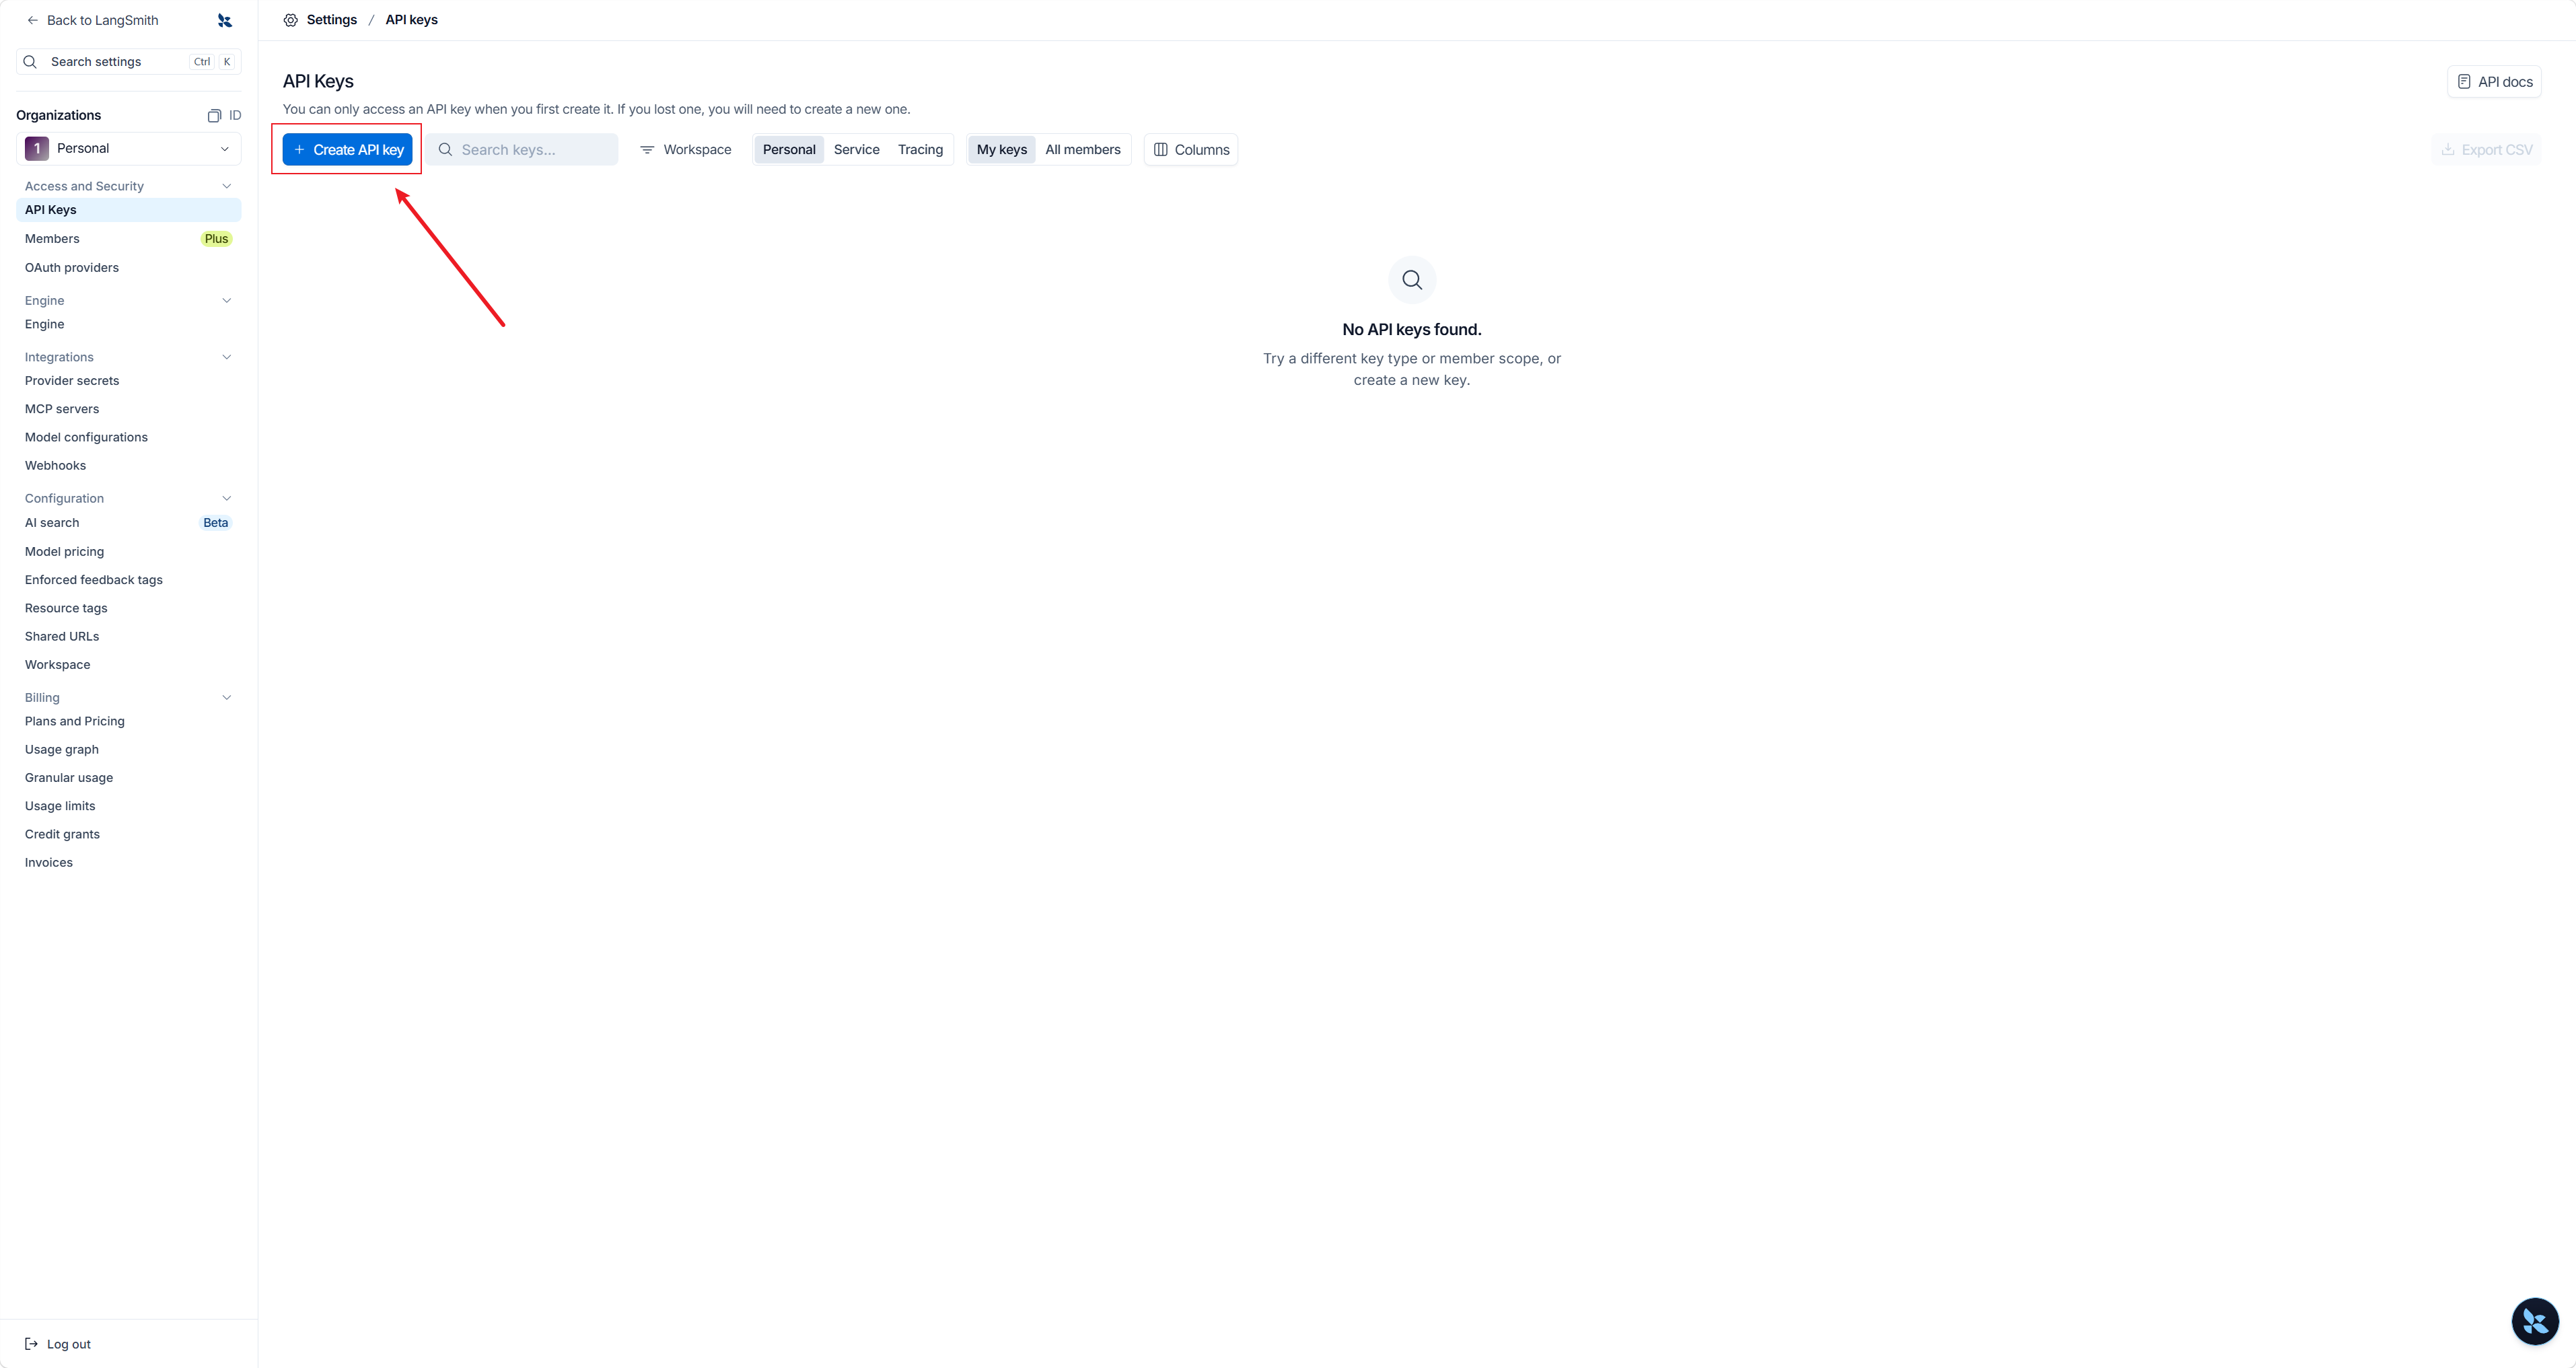
步骤2:创建 API_KEY
在左侧 Access and Security → API keys 页面,点击 + Create API key:
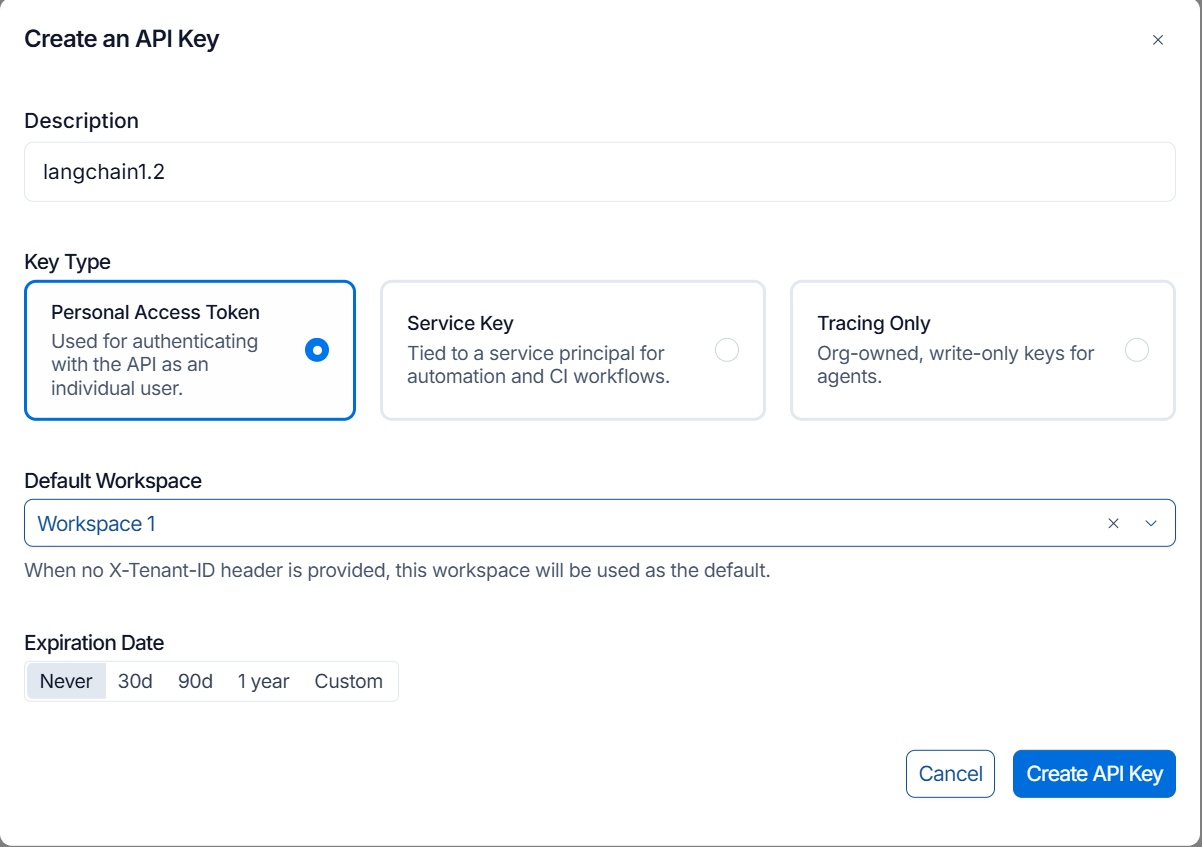
在弹窗里填写描述(如 langchain1.2),Key Type 保持默认的 Personal Access Token,Expiration Date 选 Never(或按需设有效期),然后点 Create API Key:
步骤3:保存 KEY
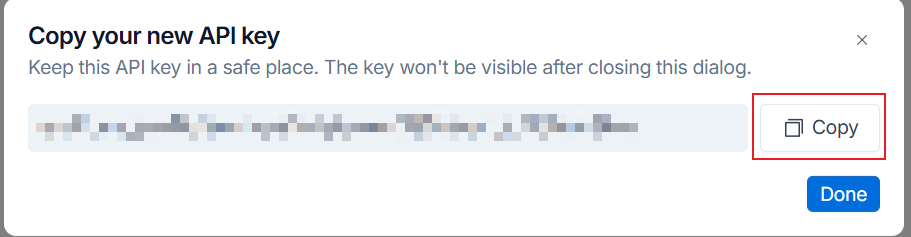
创建成功后弹出 “Copy your new API key”,点 Copy 复制到剪贴板:
只显示这一次
API Key 只在上述弹窗里出现一次,点 Done 关闭后,列表里就只剩名称和前缀,再也看不到 Key 的内容。请立刻粘贴进 .env 或密码管理器中妥善保存。
步骤4(可选):按需删除
在 API keys 列表里点右侧的删除图标即可删除旧 Key。
2.3 新增环境变量
在 .env 中补充四个环境变量——LangSmith 会读它们来决定“是否上报、上报到哪、算在哪个项目里”:
# 是否启用 LangSmith 追踪
LANGSMITH_TRACING=true

# LangSmith 的服务地址
LANGSMITH_ENDPOINT=https://api.smith.langchain.com

# 上一步创建的 API Key
LANGSMITH_API_KEY=<YOUR_API_KEY>

# 自定义项目名:WebUI 的 Tracing 页面按它分组
LANGSMITH_PROJECT="langchain1.2_tutorial"
LANGSMITH_PROJECT 可以随便起,但要和后面截图里能对得上——本页示例统一用 langchain1.2_tutorial。
3.查看监控指标
加好上面四个环境变量后,代码里只要 load_dotenv() 加载它们,之后的 LangChain 调用都会被自动记录并上报,不需要改动任何业务代码。
3.1 运行一段 LangChain 程序
任意一种初始化方式都可以,下面举三个例子。
举例1:ChatDeepSeek 直连
import os

from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

# override=True 表示 .env 优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

model = ChatDeepSeek(
    api_key=DEEPSEEK_API_KEY,
    api_base=DEEPSEEK_BASE_URL,
    model="deepseek-flash",
)

print(model.invoke("你好"))
举例2:走中转平台(ChatOpenAI 兼容接口)
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model

load_dotenv(override=True)

CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")

model = init_chat_model(
    model="deepseek-flash",
    model_provider="openai",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL,
)

print(model.invoke("你好,用一句话回答"))
举例3:带 config 的运行(会在 LangSmith 里显示自定义名称和标签)
import os

from dotenv import load_dotenv
from langchain.chat_models import init_chat_model
from rich import print as rprint

load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 1. 初始化模型,并声明哪些参数允许在运行时覆盖
model = init_chat_model(
    model="deepseek-flash",
    model_provider="deepseek",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
    temperature=0.2,
    max_tokens=500,
    configurable_fields=("model", "model_provider", "temperature", "max_tokens"),
)

# 2. 准备 config
config = {
    "run_name": "joke_generation",          # 这次运行在 LangSmith 里显示的名称
    "tags": ["my_tag1", "my_tag2"],         # 打标签,便于筛选
    "metadata": {
        "user_id": "shkstart",
        "session_id": "sess_123",
    },
    "configurable": {
        "model": "deepseek-v4-pro",         # 覆盖模型
        "model_provider": "deepseek",       # 覆盖提供商
        "temperature": 0.7,                 # 覆盖温度
        "max_tokens": 1000,                 # 覆盖最大输出长度
    },
}

# 3. 调用并传入 config
response = model.invoke("1 + 2 = ?", config=config)
rprint(response)
3.2 打开监控界面
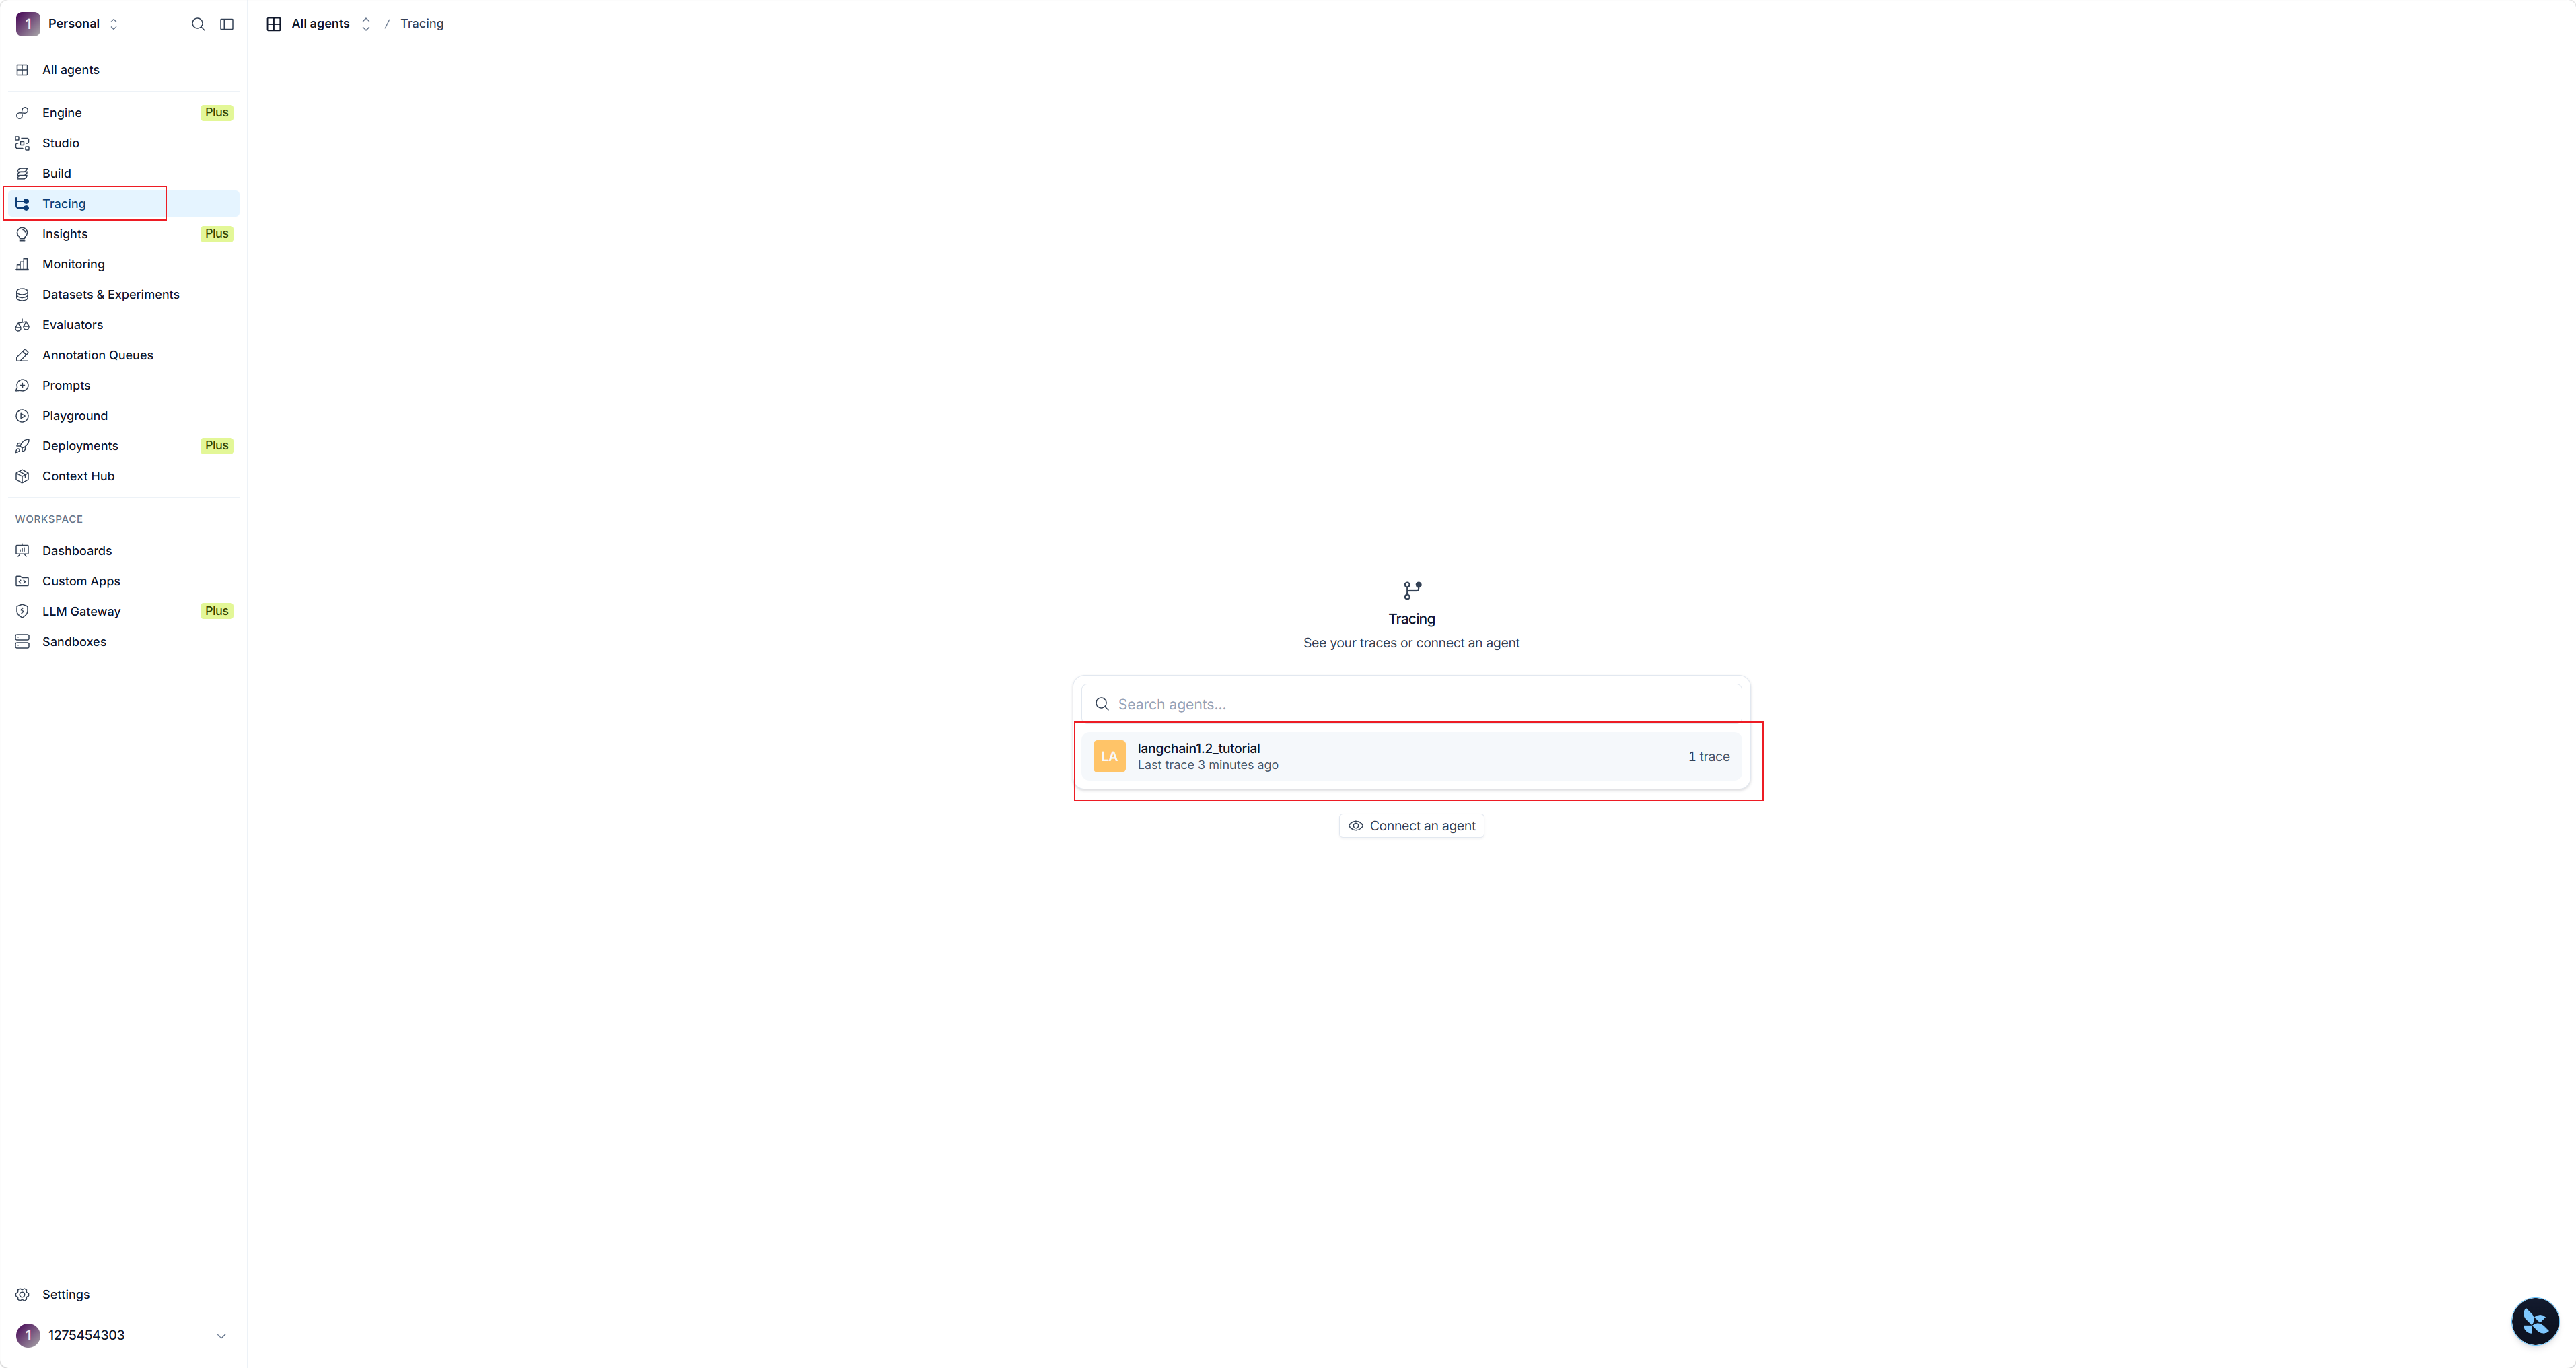
运行结束后回到 LangSmith 官网,点左侧 Tracing,就能看到以 LANGSMITH_PROJECT 命名的项目(下图是 langchain1.2_tutorial,右侧显示已收到 1 条 trace):
3.3 查看运行指标
点进项目,Tracking 页会把每次运行列成一张表:Input、Output、Latency、Tokens、Cost 等一应俱全;左侧还能按 Status、Run Name、Metadata(如 LANGSMITH_PROJECT、ls_model_name)等条件过滤:
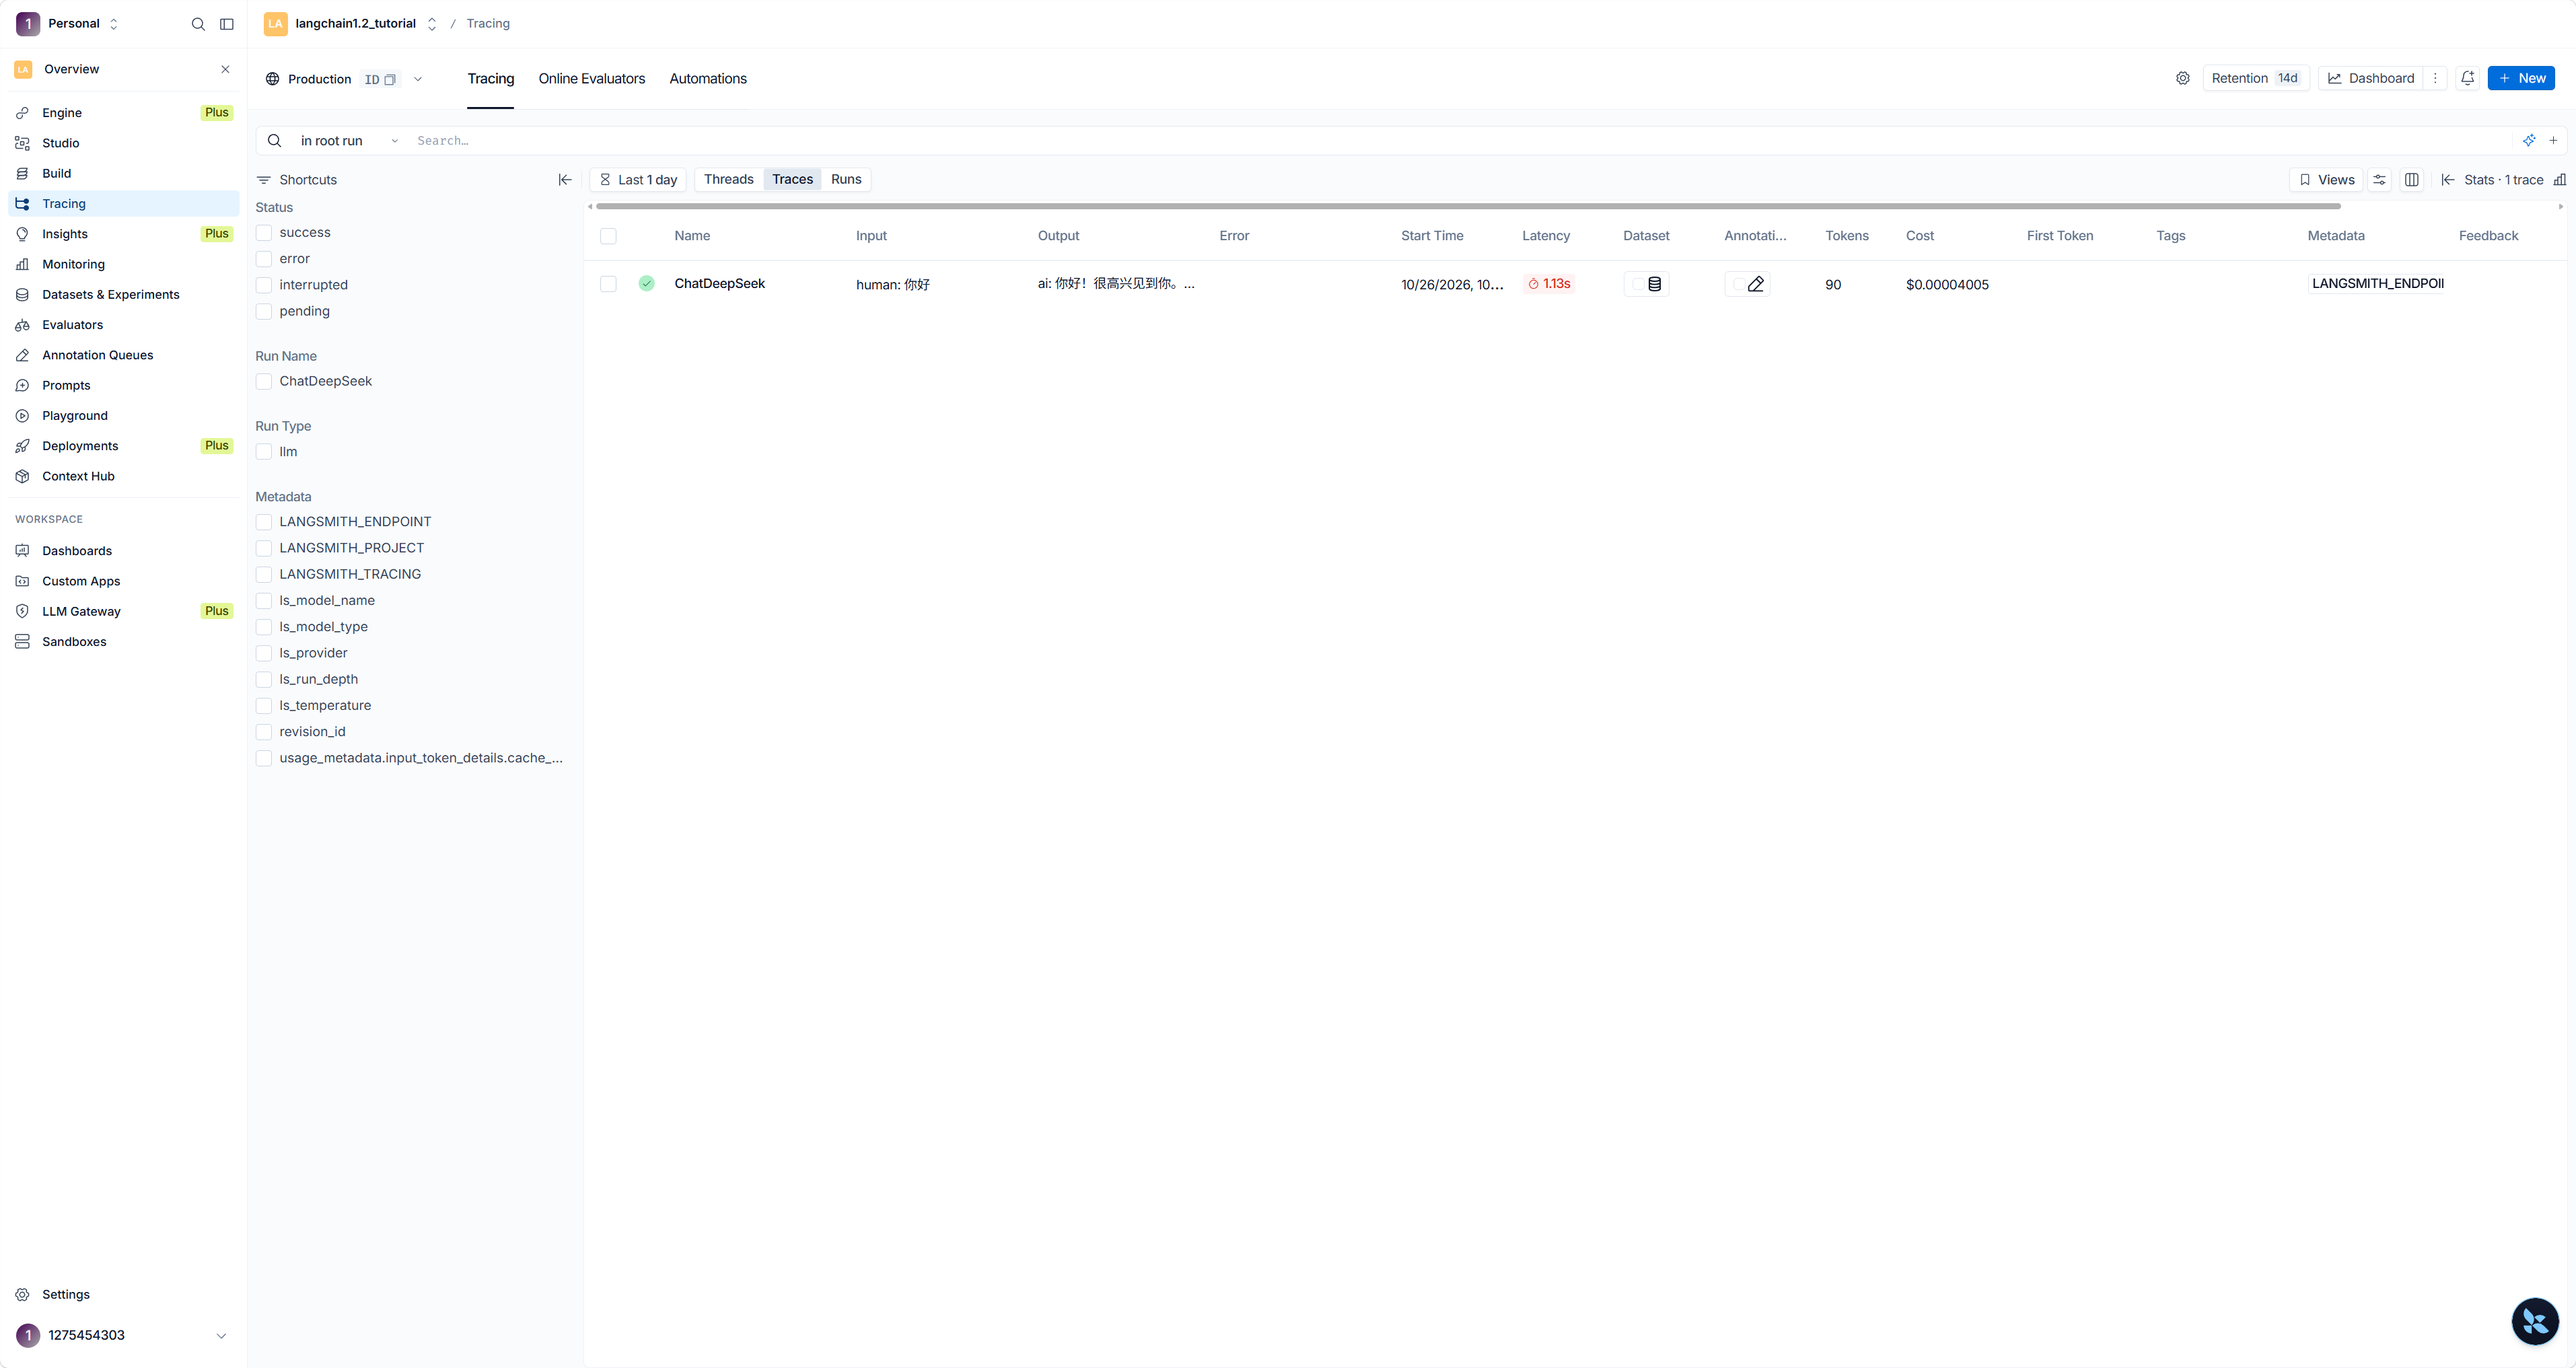
点任意一行进入详情,可以看到完整的调用链、每一步的 Prompt 与返回、耗时分解,排查问题基本就靠这一页。
3.4 查看运行报表
左侧 Monitoring → Analytics 是聚合看板,顶部有 Traces、LLM Calls、Cost & Tokens、Tools、Run Types、Feedback Scores 六个标签,每类都给出数量、延迟(P50/P99)和错误率等曲线:
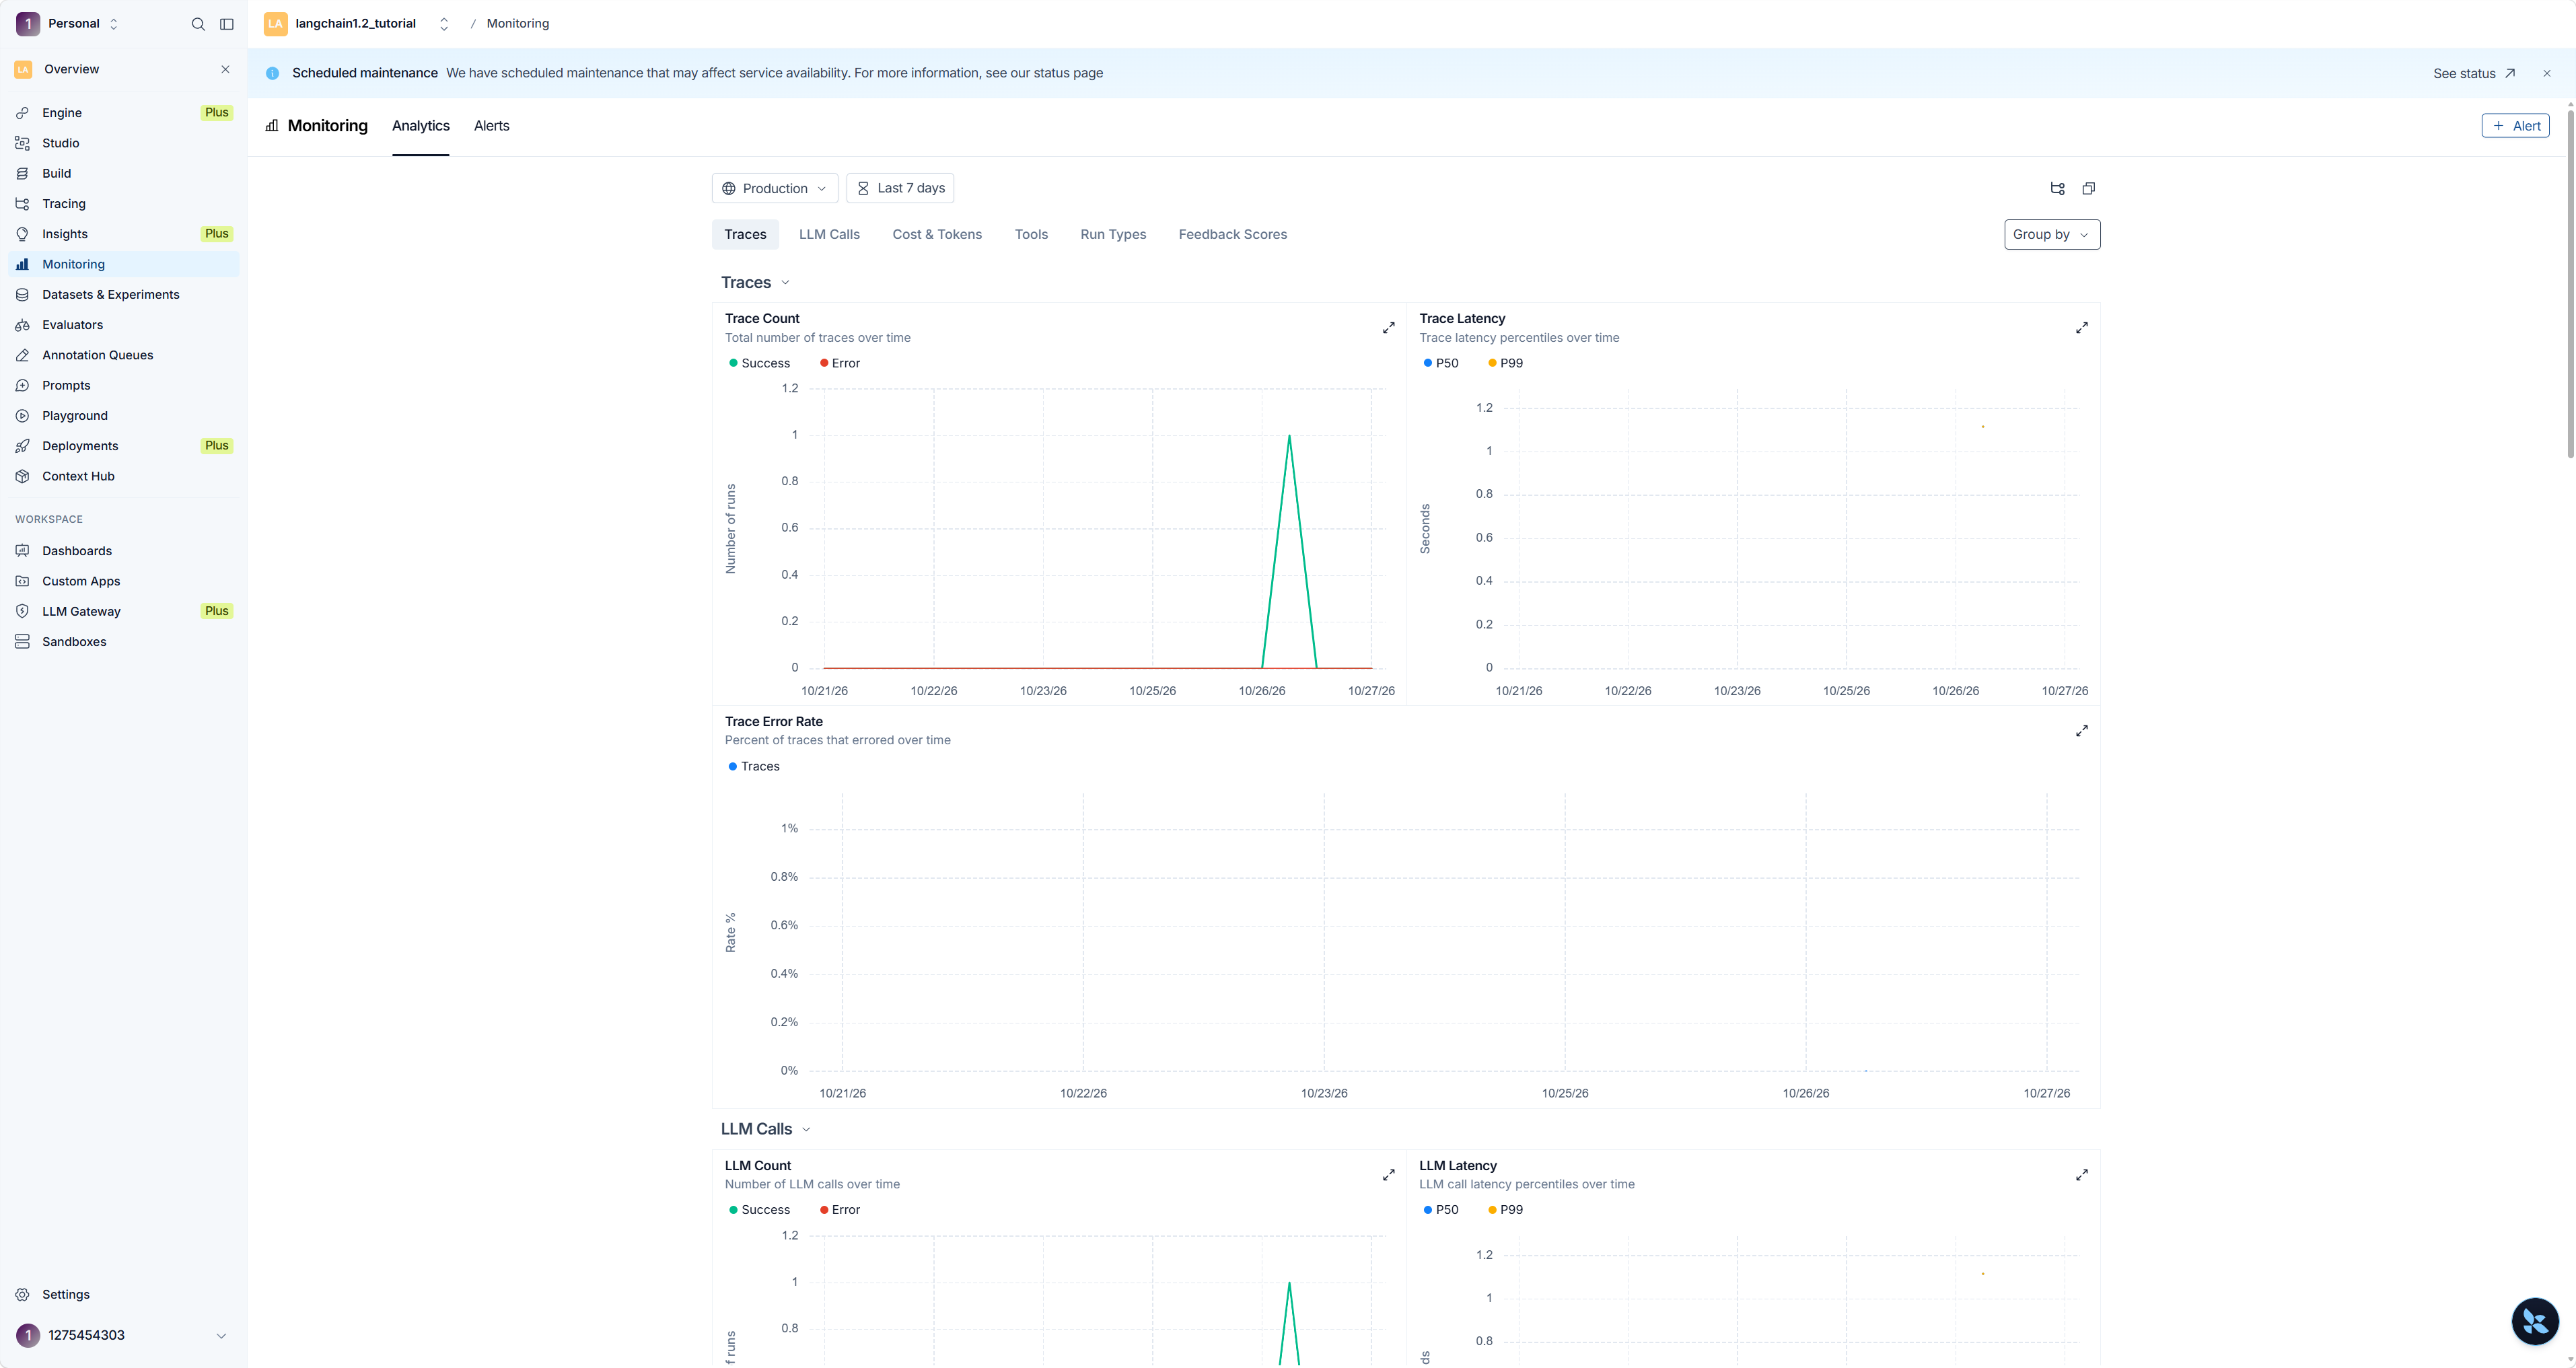
生产环境里就是靠这页看趋势:Token 消耗、QPS、错误率、成本预估都能一眼扫到。