模型的初始化
在 LangChain 中初始化模型,主要可以通过具体的模型类(Model Class)和统一的 init_chat_model() 函数这两种方式来实现。
1.使用模型类(Model Class)
LangChain 为一些大模型供应商提供了专门的 Model 类,导入对应的具体类(如 ChatOpenAI、ChatAnthropic、ChatDeepSeek、ChatOllama、ChatHunyuan、ChatTongyi、ChatZhipuAI)并进行实例化。
官网链接:https://reference.langchain.com/python/langchain-community/chat-models
1.1 通过专用 API 调用
使用不同的模型可能传入的参数名称不同,可以参考对应的源码。
1.1.1 DeepSeek 大模型
步骤 1:安装必要的依赖
执行过前面的 requirements.txt 文件指令的情况下,这里就不需要安装了。
# 切换python环境
conda activate langchain1.2

# 安装ChatOpenAI依赖包
pip install langchain-openai

# 安装ChatDeepSeek 依赖包
pip install langchain-deepseek

# 用于环境管理的包
pip install python-dotenv
langchain-deepseek 是使用 DeepSeek 大模型必要依赖。
注意
langchain-deepseek 依赖于 langchain-openai,安装前者,pip 会自动从 pypi 拉取元数据解析依赖,后者也会被安装。所以把 langchain-openai 也放在此处。
步骤 2:配置 .env 环境变量
在项目根目录下创建.env 文件,在.env 文件中写入以下内容:
DEEPSEEK_API_KEY=<Your API Key>
DEEPSEEK_BASE_URL=https://api.deepseek.com
说明
将占位符替换为自己的 API_KEY。
步骤 3:初始化并调用
用 DeepSeek 模型进行测试,LangChain 会从环境变量中读取 DEEPSEEK_API_KEY。如下是代码实现:
方式 1:指定读取环境变量
import os

from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

# 1.读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

# 2.模型的初始化
llm_deepseek = ChatDeepSeek(
    model="deepseek-flash",
    api_key=DEEPSEEK_API_KEY,
    api_base=DEEPSEEK_BASE_URL,
)

messages = [
    ("system", "你是一个简洁的助手,回答不超过两句话。"),
    ("human", "请用一句话介绍你自己"),
]

# 3.模型的调用
response = llm_deepseek.invoke(messages)
print(response)
运行结果:
(输出字段较多,这里只保留关键部分)
content='我是一个由大语言模型驱动的 AI 助手,可以回答问题、撰写文案和编写代码。'
additional_kwargs={'refusal': None, 'reasoning_content': '……(推理过程已省略)'}
response_metadata={
    'token_usage': {'prompt_tokens': 28, 'completion_tokens': 21, 'total_tokens': 49},
    'model_name': 'deepseek-flash',
    'finish_reason': 'stop'
}
id='lc_run--xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx-0'
tool_calls=[]
invalid_tool_calls=[]
usage_metadata={'input_tokens': 28, 'output_tokens': 21, 'total_tokens': 49}
基于 模型集成手册 和 LangChain Reference 的 API 参考页 ChatDeepSeek 可知相关的配置参数。
方式 2:优化,依靠默认行为读取 .env 环境变量
import os

from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

# 1.读取.env配置文件中的信息。相关的环境变量以.env文件中的优先
load_dotenv(override=True)

# 2.模型的初始化
llm_deepseek = ChatDeepSeek(
    model="deepseek-flash"
)

messages = [
    ("system", "你是一个简洁的助手,回答不超过两句话。"),
    ("human", "请用一句话介绍你自己"),
]

# 3.模型的调用
response = llm_deepseek.invoke(messages)
print(response)
说明
上面只传了 model,其余参数并不会缺失,而是会取各自的默认值——这些默认值都定义在源码里,可以直接查阅。以 ChatDeepSeek 为例:
"""The name of the model"""
api_key: SecretStr | None = Field(
    default_factory=secret_from_env("DEEPSEEK_API_KEY", default=None),
)
"""DeepSeek API key"""
api_base: str = Field(
    default_factory=from_env("DEEPSEEK_API_BASE", default=DEFAULT_API_BASE),
)
"""DeepSeek API base URL"""
DEFAULT_API_BASE = "https://api.deepseek.com/v1"也就是说,ChatDeepSeek 默认会读 DEEPSEEK_API_KEY 环境变量;api_base 则先读环境变量 DEEPSEEK_API_BASE,取不到才回落到默认的 https://api.deepseek.com/v1。这就是「方式 2」可以省略 api_key 的原因。
需要注意:默认读取的键名是 DEEPSEEK_API_BASE,而本节 .env 里写的是 DEEPSEEK_BASE_URL。所以「方式 2」只在直连 DeepSeek 官网时成立;若要改用中转/代理地址,必须像「方式 1」那样显式传入 api_base=(或把 .env 的键名改成 DEEPSEEK_API_BASE)。
方式 3:硬编码方式(不推荐)
from langchain_deepseek import ChatDeepSeek

# 创建DeepSeek LLM
deepseek_llm = ChatDeepSeek(
    api_key="sk-xxxxxxxxxxxxxxxx",  # 真实密钥不要写进代码
    api_base="https://api.deepseek.com",
    model="deepseek-flash",
)

print(deepseek_llm.invoke("请介绍一下你自己"))
1.1.2 智谱大模型
步骤 1:安装必要的依赖
# 安装 LangChain 社区依赖包,包含ChatHunyuan、ChatTongyi、ChatZhipuAI
pip install langchain-community

# ChatZhipuAI / 智谱 AI 认证相关依赖
pip install pyjwt
步骤 2:配置 .env 环境变量
在 .env 中补充:
ZHIPUAI_API_KEY=<Your API Key>
ZHIPUAI_BASE_URL=https://open.bigmodel.cn/api/paas/v4/
步骤 3:初始化并调用
import os
from langchain_community.chat_models import ChatZhipuAI
from dotenv import load_dotenv

# override=True 确保.env文件优先
load_dotenv(override=True)

ZHIPUAI_API_KEY = os.getenv("ZHIPUAI_API_KEY")
ZHIPUAI_BASE_URL = os.getenv("ZHIPUAI_BASE_URL")

zhipu_llm = ChatZhipuAI(
    model="glm-5.1",
    api_base=ZHIPUAI_BASE_URL,  #可选
    api_key=ZHIPUAI_API_KEY     #可选
)

print(zhipu_llm.invoke("请介绍一下你自己"))
1.1.3 千问大模型
通过阿里云百炼平台调用,官网:https://bailian.console.aliyun.com/
步骤 1:安装必要的依赖
# 切换python环境
conda activate langchain1.2

# ChatTongyi / 阿里通义千问依赖包
pip install dashscope
步骤 2:配置 .env 环境变量
在.env 中补充:
DASHSCOPE_API_KEY=<Your API Key>注意
一般不要添加这样的环境变量:
DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
百炼平台提供了两种访问方式:专用 SDK 和 OpenAI 兼容接口,上述 URL 是为后者准备的,而 ChatTongyi 底层是基于专用 SDK 实现的,如果指定了上述 URL,则运行报错
Traceback...
ConnectionError: ('Connection aborted.', ConnectionResetError(10054, '远
程主机强迫关闭了一个现有的连接。', None, 10054, None))
步骤 3:初始化并调用
import os
from langchain_community.chat_models import ChatTongyi
from dotenv import load_dotenv

# override=True 确保.env文件优先
load_dotenv(override=True)

DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")

tongyi_llm = ChatTongyi(
    api_key=DASHSCOPE_API_KEY,
    model="qwen-plus",
)

print(tongyi_llm.invoke("请介绍一下你自己"))
1.2 兼容用法
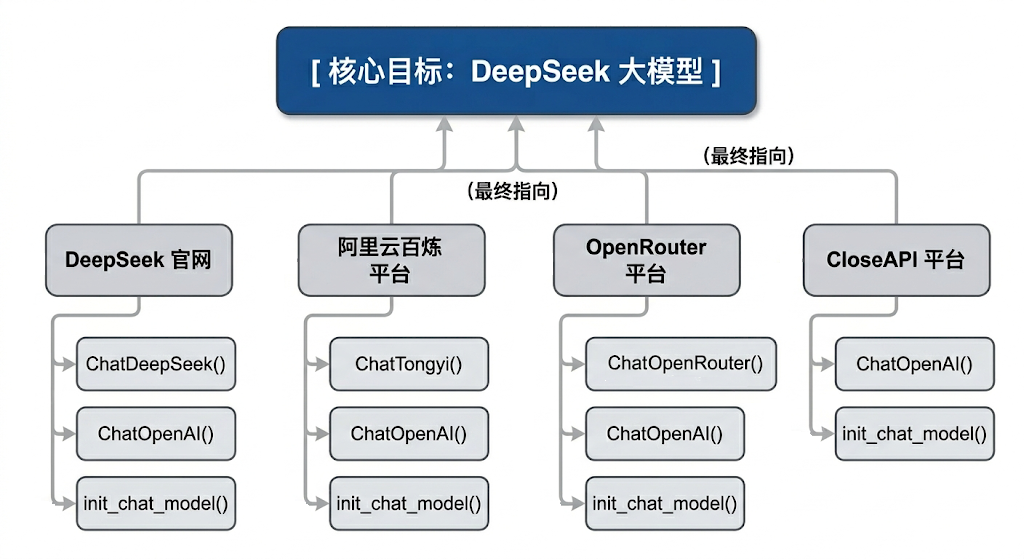
一方面,LangChain 没有为所有大模型厂商提供专用接口,见 LangChain 大模型集成列表。如果选用的平台没有专用接口,可以通过兼容接口调用。
另一方面,专用接口的对接方式五花八门,如腾讯混元的 ChatHunyuan 需要单独的 APP_ID + SecretId + SecretKey,配置繁琐,用户不友好。
结论:大多数 API 平台都支持 OpenAI API 接口规范,所以基本都可以通过 ChatOpenAI 集成。
举例 1:调用 DeepSeek 官网提供的大模型
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

import os

load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

model = ChatOpenAI(
    model="deepseek-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL
)

print(model.invoke("1 + 1 = ?"))
举例 2:调用智谱平台的大模型
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

import os

load_dotenv(override=True)

ZHIPUAI_API_KEY = os.getenv("ZHIPUAI_API_KEY")
ZHIPUAI_BASE_URL = os.getenv("ZHIPUAI_BASE_URL")

model = ChatOpenAI(
    model="glm-5.1",
    api_key=ZHIPUAI_API_KEY,
    base_url=ZHIPUAI_BASE_URL
)

print(model.invoke("请介绍一下你自己"))
1.3 中转平台
受政策影响,国内无法直接调用国外顶尖的闭源模型,某些复杂任务需要用这些模型实现,此时可以通过中转平台曲线救国。常见平台见 模型调用的准备工作 §3 的平台表,本节只讲怎么接入。
1.3.1 OpenRouter
OpenRouter 是一个多模型 API 聚合平台,提供统一的 OpenAI 兼容接口,可以通过一个 API Key 调用 OpenAI、Claude、Gemini、DeepSeek、Qwen 等不同厂商的大模型。它适合用于模型对比、模型路由、Agent 应用开发和课程实验。
步骤 1:安装必要的依赖
# OpenRouter 模型集成
pip install langchain-openrouter
步骤 2:配置 .env 环境变量
OPENROUTER_API_KEY=<YOUR_API_KEY>
OPENROUTER_API_BASE=https://openrouter.ai/api/v1
步骤 3:初始化并调用
LangChain 当前版本为 OpenRouter 提供了专用集成:ChatOpenRouter。
from dotenv import load_dotenv
from langchain_openrouter import ChatOpenRouter

import os

load_dotenv(override=True)

OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")
OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")

model = ChatOpenRouter(
    model="openrouter/free",
    api_key=OPENROUTER_API_KEY,
    base_url=OPENROUTER_API_BASE
)

print(model.invoke("一句话介绍一下你自己"))
1.3.2 CloseAI
官网:https://www.closeai-asia.com/
CloseAI 是一个面向国内用户的 AI API 中转平台,提供 OpenAI、Claude、Gemini 等模型接口的代理访问能力。它适合用于解决国内网络访问、支付和接口统一管理等问题,常用于大模型应用开发、教学演示和测试环境。
LangChain 没有为 CloseAI 提供专用集成,可以通过 ChatOpenAI 兼容接口调用。
步骤 1:配置 .env 环境变量
在 .env 中补充(接口地址以平台控制台为准):
CLOSEAI_API_KEY=<Your API Key>
CLOSEAI_BASE_URL=<Your Base URL>
步骤 2:初始化并调用
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI

import os

load_dotenv(override=True)

CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")

model = ChatOpenAI(
    model="gpt-5-mini",
    api_key=CLOSEAI_API_KEY,
    base_url=CLOSEAI_BASE_URL
)

print(model.invoke("请介绍一下你自己"))
2.init_chat_model()
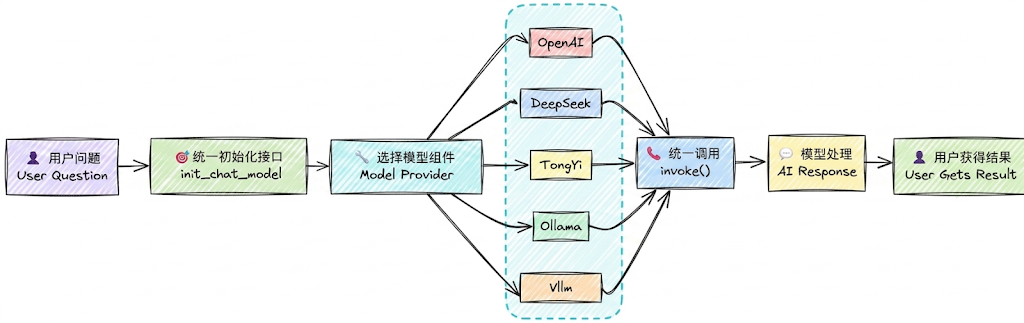
init_chat_model 是 LangChain 1.x 中推出的用于初始化聊天模型的统一接口。只要是 LangChain 支持的模型都可以处理,它会根据模型名称自动选择对应的模型类初始化实例。
2.1 基本语法
from langchain.chat_models import init_chat_model
model = init_chat_model(
    model="provider:model_name",   # 提供商:模型名称
    api_key="your-api-key",        # API 密钥(可选,可从环境变量读取)
    temperature=0.7,               # 温度参数(可选)
    max_tokens=1000,               # 最大 token 数(可选)
    **kwargs                       # 其他模型特定参数
)
init_chat_model 和直接使用 ChatTongyi、ChatOpenAI、ChatDeepSeek 的区别
init_chat_model 是 LangChain 1.0 的统一接口,优势包括:
- 统一接口:无需记住每个提供商的不同初始化方式(以一致的方式初始化)
- 易于切换:简化了智能体系统中模型切换策略(只需修改模型字符串)
- 简洁明了:更简洁的语法,减少样板代码
- 自动适配:内部根据模型标识自动选择对应的驱动类(ChatOpenAI、ChatDeepSeek)
2.2 举例
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

import os

load_dotenv(override=True)

DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")

model = init_chat_model(
    # model="deepseek-flash",
    # model_provider="deepseek",
    # 或者
    model="deepseek:deepseek-flash",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL
)

print(model.invoke("请介绍一下你自己"))
2.3 model_provider 的可选取值
model_provider 表示模型的提供者,支持的 providers 有:anthropic, anthropic_bedrock, azure_ai, azure_openai, bedrock, bedrock_converse, cohere, deepseek, fireworks, google_anthropic_vertex, google_genai, google_vertexai, groq, huggingface, ibm, mistralai, nvidia, ollama, openai, openrouter, perplexity, together, upstage, xai(共 24 个,随版本变化,可在 init_chat_model 源码的 _BUILTIN_PROVIDERS 中确认)。
- 如果
model_provider="openai",会自动加载langchain-openai的依赖包,底层调用的是 ChatOpenAI 类。 - 如果
model_provider="deepseek",会自动加载langchain-deepseek的依赖包,底层调用的是 ChatDeepSeek 类。 - 像阿里的
dashscope尚未被 LangChain 官方纳入模型的统一注册体系,暂时不知道“dashscope”的提供者是谁。此时可以将 model_provider 设置为 openai,底层将会用 openai 的规范处理请求,这就要求我们调用的模型服务是 OpenAI Compatible 的。
2.4 供应商的三种指定方式
可以在 model 参数中通过前缀指定模型供应商,和模型名称之间用冒号(:)分割,等价于通过 model_provider 参数指定供应商。如果两个位置都没有指明供应商,LangChain 底层会按照内置规则自动推断。
但是,并非所有的模型都支持自动推断,如 model 名称 qwen-plus 不支持自动推断,没有指明供应商会报错。
2.5 模型初始化参数(常用版)
Model Class(如 ChatDeepSeek)与 init_chat_model() 使用同一套初始化参数。下面只列出日常开发中最常用的几个,更完整的参数列表见 模型初始化参数(完整版)。
API 文档:https://docs.langchain.org.cn/oss/python/langchain/models#parameters
| 参数 | 类型 | 说明 | 默认值 |
|---|---|---|---|
| model | str | 使用的特定提供商的模型名称(必需)。比如:openai:gpt-4o、groq:gemma2-9b-it | 无 |
| model_provider | str | 模型提供商名称(仅 init_chat_model() 使用) | 无 |
| api_key | str | API 密钥。如果不提供,会从环境变量中读取(如 DEEPSEEK_API_KEY) | None |
| base_url | str | 大模型供应商API请求地址 | None |
| temperature | float | 控制输出随机性,范围 0.0-2.0,温度越高输出越随机。 - 0.0:最确定性,输出几乎不变- 1.0:平衡创造性和一致性- 2.0:最随机,最有创造性 | None |
| max_tokens | int | 限制模型输出的最大 token 数量 | None |
| timeout | float | 超时时间(秒),超时未响应,请求会被取消 | None |
| max_retries | int | 请求失败(如网络问题、速率限制)时的最大重试次数 | None |
表中 None 表示 LangChain 不预设默认值——不传就由模型服务端或底层 SDK 决定(例如 DeepSeek 的 temperature 服务端默认为 1.0)。另外,base_url 是 ChatOpenAI 风格的参数名,api_base 是 ChatDeepSeek、ChatZhipuAI 风格的参数名,二者指向同一个地址,ChatDeepSeek 两种都接受。
说明
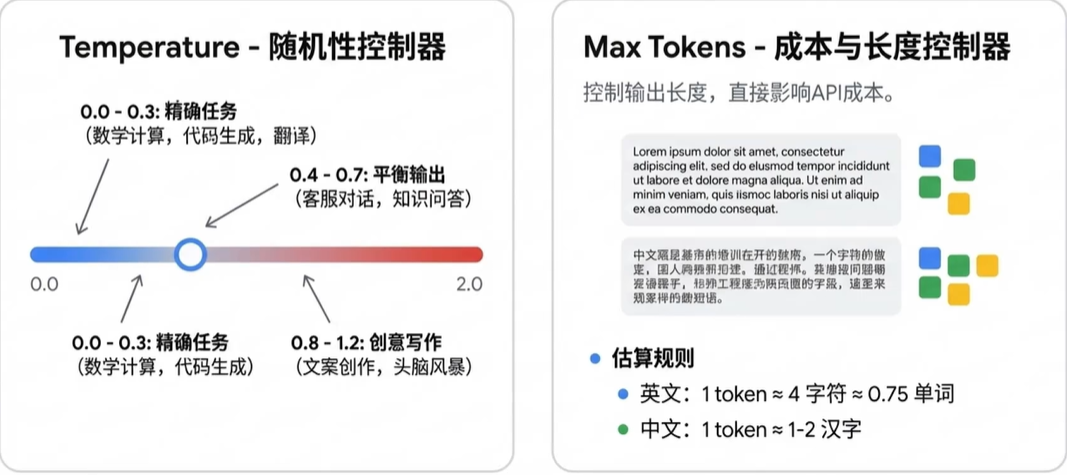
- temperature 参数根据使用场景选择:
- 0.0-0.3:需要一致性、准确性的任务(数学计算、数据提取、分类、代码生成)
- 0.5-0.7:平衡创造性和一致性(聊天、问答)
- 0.8-1.5:创造性任务(写作、头脑风暴)
- 1.5-2.0:高度创造性(诗歌、故事创作)
- Token 是什么?
基本单位: 大模型通过分词器(Tokenizer)将文本拆分后的最小语义单元是 token(相当于自然语言中的词或字)。不同的模型采用不同的分词算法(如 BPE、WordPiece),因此同一段文本在不同模型中的 Token 数量可能不同。
收费依据:大语言模型通常也是以 token 的数量作为其计量(或收费)的依据。
- 1 个中文 Token≈1-1.8 个汉字,1 个英文 Token≈3-4 个字符
- Token 与字符转化的可视化工具:
3.本地模型的部署与调用
3.1 Ollama 介绍
LangChain 也支持使用 Ollama、vLLM 等框架启动的本地大模型,这里以 Ollama 为例。
Ollama 是在 GitHub 上的一个开源项目,其项目定位是:一个本地运行大模型的集成框架,可以实现如 Qwen、DeepSeek 等主流大模型的下载、启动和本地运行的自动化部署及推理流程。
Ollama 官方地址:https://ollama.com
3.2 Ollama 的常用命令
安装步骤、自定义安装目录(/DIR 参数)、OLLAMA_MODELS 模型存放路径等,在基础篇2.2 Ollama 本地部署 · Python 基础教程已有完整说明;这里只做常用命令速查。
| 命令 | 一句话说明 |
|---|---|
| ollama pull llama3 | 下载指定模型(例:llama3) |
| ollama run llama3 | 启动并进入该模型交互对话 |
| ollama list | 列出本机已下载的所有模型 |
| ollama rm llama3 | 删除不再需要的模型以节省磁盘 |
| ollama cp llama3 my-llama3 | 本地复制/重命名模型 |
| ollama show llama3 | 查看模型详细信息(参数、大小等) |
| ollama create my-model -f Modelfile | 用自定义 Modelfile 构建新模型 |
| ollama serve | 启动后台服务,供 API 调用 |
| ollama ps | 查看当前正在运行的模型进程 |
| ollama stop llama3 | 停止正在运行的模型 |
| ollama --version | 查看安装的ollama版本 |
3.3 LangChain 调用模型
方式 1:使用具体的类
from langchain_ollama import ChatOllama

model = ChatOllama(
    model="deepseek-r1:1.5b",
    # 如果Ollama在本地默认端口运行,则可省略,或使用http://localhost:11434
    base_url="http://localhost:11434"
)

print(model.invoke("介绍一下你自己"))
方式 2:使用 init_chat_model()
from langchain.chat_models import init_chat_model

model = init_chat_model(
    model="deepseek-r1:1.5b",
    model_provider="ollama",
    base_url="http://localhost:11434"
)

print(model.invoke("介绍一下你自己"))